
2026年9月24日,人工智能学院在15栋322召开了科研六组例会。陈菁菁老师汇报了课题组在多模态推理与具身智能方面的最新研究进展。重点阐述了基于视觉对象级内在优势的多模态推理策略优化方法(POLIA)及多智能体战略推理框架(Strat-Reasoner),展示了模型在多模态推理基准和博弈任务中的有效性。主要内容如下:
一、论文分享
POLIA: Policy Optimization with Visual-Object-Level Intrinsic Advantage for Multimodal Reasoning
1.研究背景与问题
多模态大模型已能同时处理图像与文字,完成物体计数、空间关系判断、图表分析和视觉数学推理等任务。然而,能回答不等于真理解——模型可能忽略图像关键信息,仅靠语言模式猜对答案,也可能引用了错误视觉对象却碰巧得到正确结论。表面正确,推理依据却与视觉事实不一致。这不仅是聊天机器人的小瑕疵,更是具身智能大脑必须跨越的认知门槛。
当前多模态大模型在训练过程中主要依赖答案级外在奖励进行优化,即仅根据最终答案的正确性来计算奖励信号。这种方案存在以下问题:
(1)答案级奖励无法区分模型是真正理解了视觉内容还是通过语言先验猜对了答案,导致模型学会表面正确但推理依据错误的捷径策略。
(2)在多模态推理任务中,模型需要引用图像中的特定视觉对象作为推理证据,但现有方法缺乏对视觉对象引用准确性的细粒度监督信号。
(3)传统强化学习方法在处理多模态信息时,难以有效建模视觉对象与语言之间的细粒度对应关系,导致训练效率低下。
2. 提出的算法与关键技术
汇报重点阐述了一种名为POLIA的强化学习方法,全称为基于视觉对象级内在优势的多模态推理策略优化。该方法在传统答案级评价之外,增加了针对视觉对象的细粒度评价机制,分为两个阶段:
(1)答案级外在奖励(第一阶段)
POLIA生成多组候选答案,根据最终答案的正确性和输出格式计算答案级外在奖励,回答模型最终有没有答对。这一步与传统基于组相对策略优化(GRPO)的方法类似,通过比较同一问题下不同候选答案的优劣来生成训练信号。
(2)视觉对象级内在奖励(第二阶段)
POLIA识别每组候选答案所引用的视觉对象,根据模型预测位置与真实对象位置之间的匹配质量,判断模型引用对象的可靠程度。依赖相同视觉对象的答案被归入同一组,系统再在组内比较不同答案对这些对象的使用情况,为每个视觉对象计算训练反馈。这种两阶段奖励计算机制确保了模型不仅关注答案的正确性,还关注推理过程中视觉证据的准确性。
(3)多智能体战略推理框架(Strat-Reasoner)
汇报还介绍了同一团队在同一届ICML 2026上发表的另一项成果Strat-Reasoner。该方法面向多智能体博弈场景,引入了一种递归推理范式,其中智能体的推理过程还整合了其他智能体的推理过程。具体而言,模型在采取行动前,依次思考对方上一轮的意图、对方如何判断自己、自己当前希望实现的目标,以及对方下一轮可能采取的行动。训练过程中,系统还会将模型对对方的预测与对方实际表达的意图和最终行动进行比较,再结合整场博弈结果,共同优化模型的战略推理能力。通俗来说,传统强化学习主要判断最后赢没赢;Strat-Reasoner还会继续追问:你是否真正理解了对方?你的预测是否被下一步行动验证?最终结果来自有效推理,还是偶然发生。
3、 初步验证与应用场景
(1)多模态推理基准验证:
POLIA在VSR、TallyQA、GQA、MathVista、MathVision、LogicVista和MME等七项多模态推理基准上进行了测试,覆盖空间关系判断、复杂物体计数、视觉数学推理和综合认知等任务。在7B模型实验中,相比基于相同基础模型的GRPO方法,POLIA在VSR、TallyQA、GQA和MathVista上准确率分别提升22.3、8.7、11.3和9.3个百分点;在高度依赖视觉证据的任务中,POLIA-7B的分数高于GPT-4o和Gemini 2.5 Pro对照结果。
(2)多智能体博弈任务验证:
Strat-Reasoner以Qwen3-4B为基础模型,在三类多智能体游戏、超过500局评测中实现平均22.1%的战略表现提升。在Kuhn Poker两种行动顺序测试中,其得分均高于GPT-5-mini和Gemini 2.5 Flash。实验还显示,Strat-Reasoner在未参与训练的游戏环境中仍保持较强表现,说明模型学习到的战略推理方式具有一定的跨环境迁移能力。
二、组员讨论
汇报结束后,与会老师围绕多模态推理方法的实际可行性、潜在挑战及下一步的研究方向展开了热烈讨论。
梁佳佳老师指出,POLIA方法在多模态推理基准上取得了显著进步,但当前实验主要基于静态图像-文本对,而实际具身智能场景中的视觉输入往往是动态视频流,且存在遮挡、光照变化等挑战。此外,视觉对象级奖励的计算依赖于精确的对象检测和定位能力,这在复杂场景中可能面临精度不足的问题。未来可探索结合世界模型方法,引入时序建模能力,使模型能够更好地理解动态场景中的因果关系。
周文娟老师关注多智能体战略推理方法在实际部署中的计算复杂度问题。Strat-Reasoner需要在每一步推理中模拟其他智能体的意图和行动,计算开销较大。此外,当前方法主要在双智能体交替博弈环境中完成验证,尚未扩展到多智能体同时行动的真实场景。下一步应探索更高效的推理近似方法,并在多机器人协同、自动驾驶等真实场景中开展验证。
三、会议总结
陈菁菁老师对本次汇报和讨论进行了总结:本次汇报围绕多模态推理与具身智能展开了系统性的学术交流。研究针对多模态模型表面正确但推理依据错误的核心问题,提出了POLIA方法及递归推理框架,并在多项基准上验证了其优越性。与会老师对视觉对象级奖励机制的创新性及多智能体战略推理的有效性给予了充分肯定,同时也就动态场景适配、计算效率及真实场景验证等现实挑战提出了建设性意见。
经科研小组内部讨论,下一步工作将聚焦三个方向:其一,引入世界模型与时序建模能力,提升模型在动态视觉场景中的推理鲁棒性;其二,探索更高效的多智能体通信协议与协同机制,推动从双智能体博弈向多智能体协同的扩展;其三,将方法部署到真实具身机器人平台,在物理环境中开展长期在线验证,以缩短基础研究到工程应用的转化周期,为智能体从看懂世界到理解他者的演进提供技术支撑。
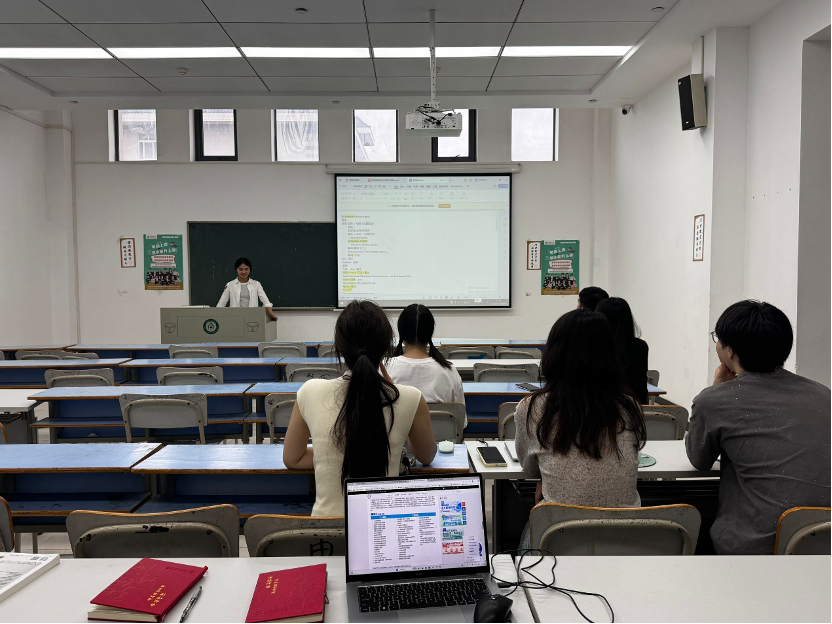
图为陈菁菁老师正在进行论文讲解
