
2026年9月10日,人工智能学院在15栋322召开了科研六组例会。蒲万徐老师分享了一篇数据挖掘领域IEEE Xplore 会议论文,围绕大语言模型与知识图谱融合的学术资源知识发现架构展开研讨,重点分析了三层式知识发现体系的设计逻辑、核心技术及其在数据集上的验证效果。主要内容如下:
一、论文分享:Knowledge Discovery from Scholarly Resources using Large Language Model and Knowledge Graph
1.研究背景与问题
学术资源(含科学文献、研究数据等)呈指数级增长,全球每年发表超514 万篇学术论文,传统学术搜索引擎基于关系数据库返回检索结果,普遍缺乏对文献内容的深度分析,研究人员难以在细分专业领域精准获取所需知识,“学术大数据” 的价值挖掘效率亟待提升。
大语言模型(LLM)在问答、摘要、文本生成等自然语言任务中表现突出,但在复杂专业知识推理场景下存在明显幻觉,易生成事实错误内容,无法满足科研场景对准确性、可解释性与透明度的严苛要求。现有研究提出 “LLM⊗KG” 融合范式,通过引入外部知识图谱(KG)辅助大模型推理,但面向学术资源的全链路、分层级知识发现架构仍不完善,如何全面精准地挖掘并呈现细分领域的专业内容,是该领域的核心挑战。
2.整体架构与核心思路
本文提出一套融合大语言模型与知识图谱的学术资源知识发现架构,自上而下分为数据采集与富集、知识抽取与融合、知识发现服务三层,实现文献级与领域知识级的双层知识发现。
底层通过多源采集与语义增强构建高质量数据底座;
中层结合大模型、深度学习方法与知识图谱工具,完成多类型数据的知识抽取、融合与校验;
上层面向科研场景设计多模式服务,支撑不同维度的知识发现需求。
3. 实验验证
该论文以水稻育种领域为案例完成实证验证,围绕绿色、高效、多抗、优质、高产、功能性六大育种目标构建数据集,包含:1 万余条关联文献的科学数据记录、150 万条引用数据、7856 篇PMC 全文文献、4 万余条Web of Science 文献元数据。
二、组员讨论
1. 关于三层架构设计与耦合机制的讨论
杨喆老师观点:三层架构边界清晰、逻辑递进,特别是将语义知识库前置到数据富集层,而非仅在抽取环节做补充,从数据源头就注入了领域先验知识,这是提升后续抽取质量的关键设计。同时提出疑问:对于没有成熟领域叙词表的小众学科,数据富集层的语义增强该如何落地,是否可以通过LLM 自动生成轻量本体来弥补。
张芸老师补充:该架构采用LLM 与KG 松耦合的设计,KG 负责结构化存储与事实校验,LLM 负责非结构化文本理解,两者的交互集中在知识抽取与验证环节,这种模式便于后续单独替换大模型或图数据库组件,工程可维护性更强,也方便针对不同领域做定制化适配。
2. 关于知识抽取质量与幻觉缓解的讨论
别岳超观点:三重校验机制是这篇论文的核心亮点之一,学术场景对知识准确性零容忍,必须有外部真值作为锚点。但目前的验证主要集中在实体层面,关系、属性的校验规则相对简单,复杂语义关系(如基因- 表型的因果关联)的准确性仍依赖人工抽检,后续可以设计更精细的关系级校验逻辑。
周文娟观点:30 篇文献抽取出2000 + 候选基因最终仅保留330 个,说明原生LLM 的抽取噪声率很高,也反向证明了KG 校验的必要性。但如果面对十万级以上的大规模文献库,全量调用外部知识库校验的成本会非常高,建议设计置信度分层机制,高置信结果直接入库,仅低置信结果触发外部校验。
3. 关于服务场景与落地价值的讨论
孟艳平老师观点:自然语言检索将用户提问转化为图查询语言,大幅降低了科研人员使用知识图谱的门槛,落地实用性很强。但目前的意图识别仅覆盖作者、机构、主题、时间等基础维度,对于 “对比不同方法的优劣”“总结某方向的研究演进” 这类深度情报需求还无法支持,服务深度仍有拓展空间。
许子龙老师观点:原型系统目前只开放了中文版本,而核心学术资源大多以英文为主,多语言适配是大范围推广的必要前提。此外论文中提到的 “数据- 文献关联” 功能着墨较少,这一功能对追溯科研数据的证据链、支撑学术诚信价值很大,可以作为后续深化的重点。
三、会议总结
蒲万徐老师对本次汇报和讨论进行了总结:
(1)本文的核心贡献是构建了一套完整的 “LLM+KG” 学术知识发现工程化架构,将大语言模型的文本理解能力与知识图谱的结构化校验能力深度结合,破解了纯大模型在学术场景下的幻觉难题,实现了从文献资源到领域知识的分层、精准挖掘;
(2)在数据集的全流程验证与原型系统落地,证明了架构的实际应用价值,多场景服务设计贴合科研人员核心需求,为垂直领域学术知识服务系统的建设提供了可复用的参考范式;
(3)组内讨论一致认为,当前架构在成熟垂直领域表现优异,但面向通用化学术资源的规模化应用,仍面临领域迁移成本高、复杂推理能力不足、大规模处理效率受限等多重挑战。
经课题组讨论,下一步工作将聚焦三个方向:
其一,探索低资源领域的知识发现适配方法,研究小样本prompt 学习与大模型驱动的自动本体构建技术,降低跨领域迁移的人工成本;
其二,优化知识抽取与校验的运行效率,设计置信度驱动的分层校验机制,同时引入GraphRAG 框架提升多跳知识推理与复杂查询的处理能力;
其三,拓展深度知识服务场景,新增研究趋势分析、文献综述自动生成、方法对比等情报功能,同时推进系统多语言适配与性能优化,支撑更大规模学术资源的知识发现。
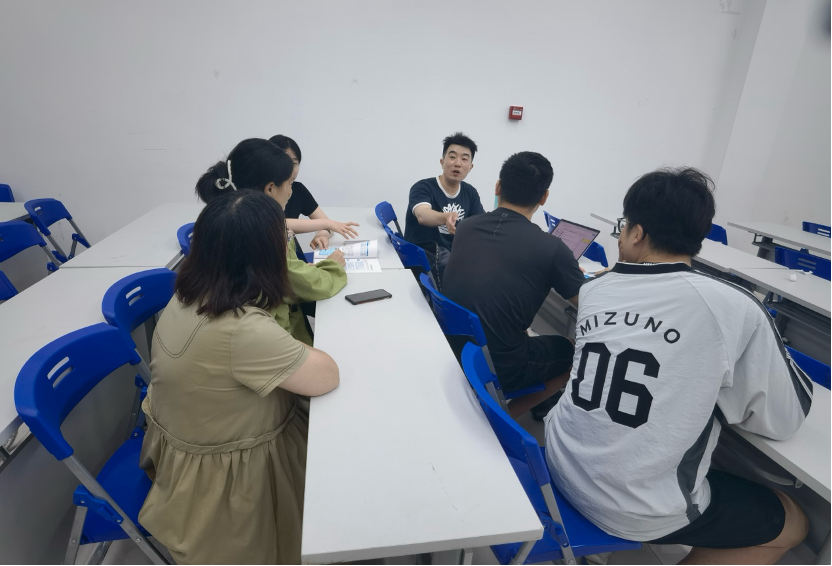
图为蒲万徐老师正在进行论文讲解
